過去兩年我們對 AI 的想像都是「它會寫」——寫文案、寫程式、寫報告。9 月 15 日有一個模型反過來走:它一個字都不會寫,只做選擇題。這個叫 Jev 的東西一週內衝上開發圈熱搜,但同一週也被一個免費的開源模型正面挑戰。這篇用白話把它講清楚,順便講為什麼那些「快 200 倍」的數字要自己驗一下。

先講一個生活裡的場景
你在餐廳門口跟服務生說「我要內用,四個人」。服務生不需要跟你討論菜系流派,他只要判斷三件事:內用還外帶、幾位、要不要兒童椅,然後帶你入座。這三個判斷加起來大概兩秒。
現在想像一下,如果每次有人走進門,你都得先請一位讀過整套餐飲百科的顧問出來,他花三十秒寫一段落落長的分析告訴你「根據顧客的表達,他傾向於內用,人數推測為四人」——你不會這樣開店。
但這正是很多 AI 流程現在的樣子。一個只要判斷「這封信是不是垃圾信」的動作,被丟給一個會寫小說的大模型去想,慢、貴,而且它還可能自由發揮講出你沒預期的東西。
Jev 要解的就是這件事。
Jev 是什麼:AI 選擇題,不是 AI 作文
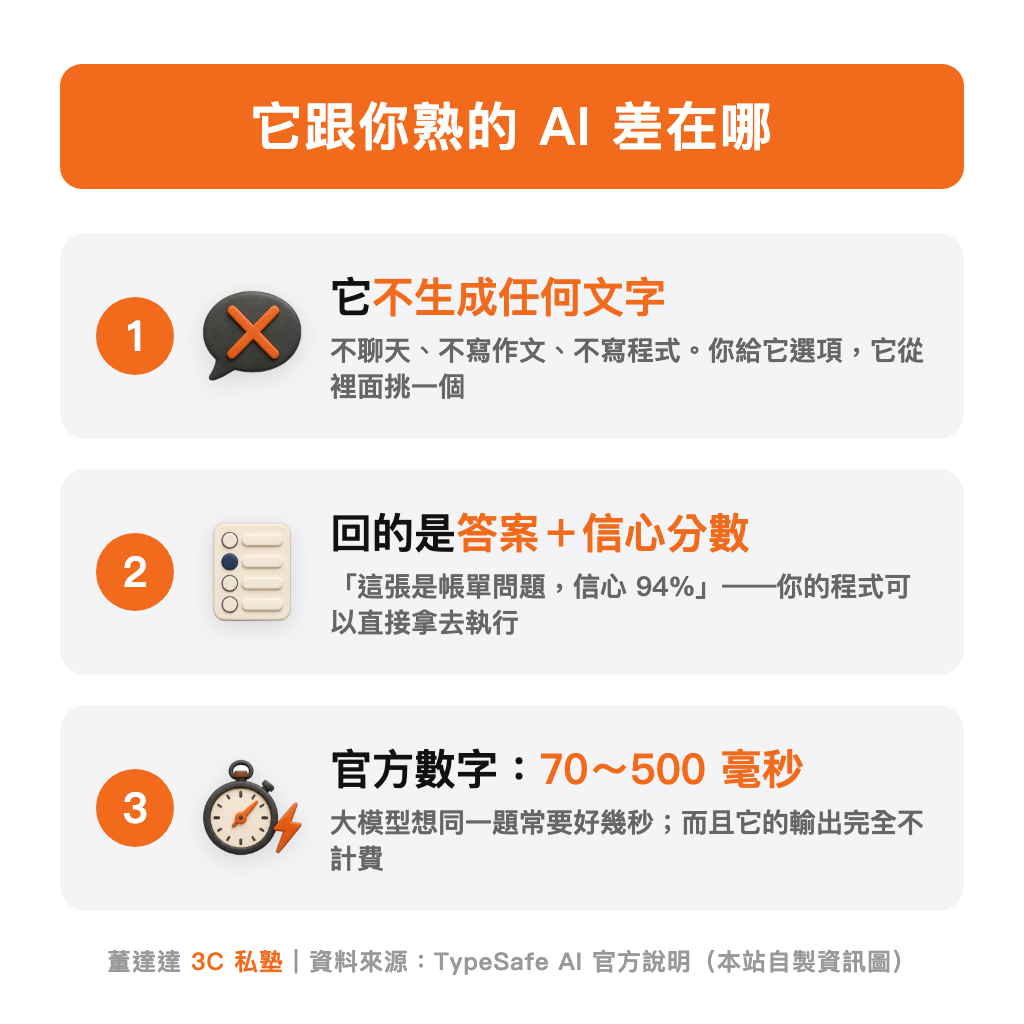
目前網路上最好懂的一句解釋,出自一位開發者的貼文:「想成 AI 選擇題,不是 AI 作文。它不聊天,它做出你的軟體可以直接執行的決定。」
具體一點,它的運作是這樣:
- 你先定好選項:例如「帳單問題/技術問題/退貨/其他」
- 把原始內容丟給它:一封客訴信、一則對話紀錄、一張表單
- 它回一個答案加一個信心分數:「帳單問題,信心 94%」
它不會多寫一個字。也因為它只在你給的選項裡挑,程式收到答案可以直接拿去執行下一步,不用再寫一堆程式去解析它到底想說什麼。
官方給的數字是:延遲 70 到 500 毫秒,比同類任務用大模型快約 200 倍、便宜約 400 倍,而且輸出完全不計費,只算你丟進去的部分。
「System One」這個詞怎麼來的
心理學把人的思考分成兩種:系統一是快思,看到紅燈就踩煞車,不用想;系統二是慢想,算數學題、規劃行程那種。
現在的 ChatGPT、Claude、Gemini 全都在做系統二的事——它們慢慢想、一步步推理、寫出完整答案。Jev 自稱是第一個專門做系統一的模型:快、直覺、只給判斷。
做這個模型的公司叫 TypeSafe AI,舊金山團隊、2024 年成立,共同創辦人暨執行長之前在 OpenAI 做的是後來變成 ChatGPT 的指令遵循研究。9 月 15 日發表時同步宣布 4,000 萬美元種子輪,9 月 20 日就因為需求太大取消候補名單、全面開放。
大家實際拿它做什麼
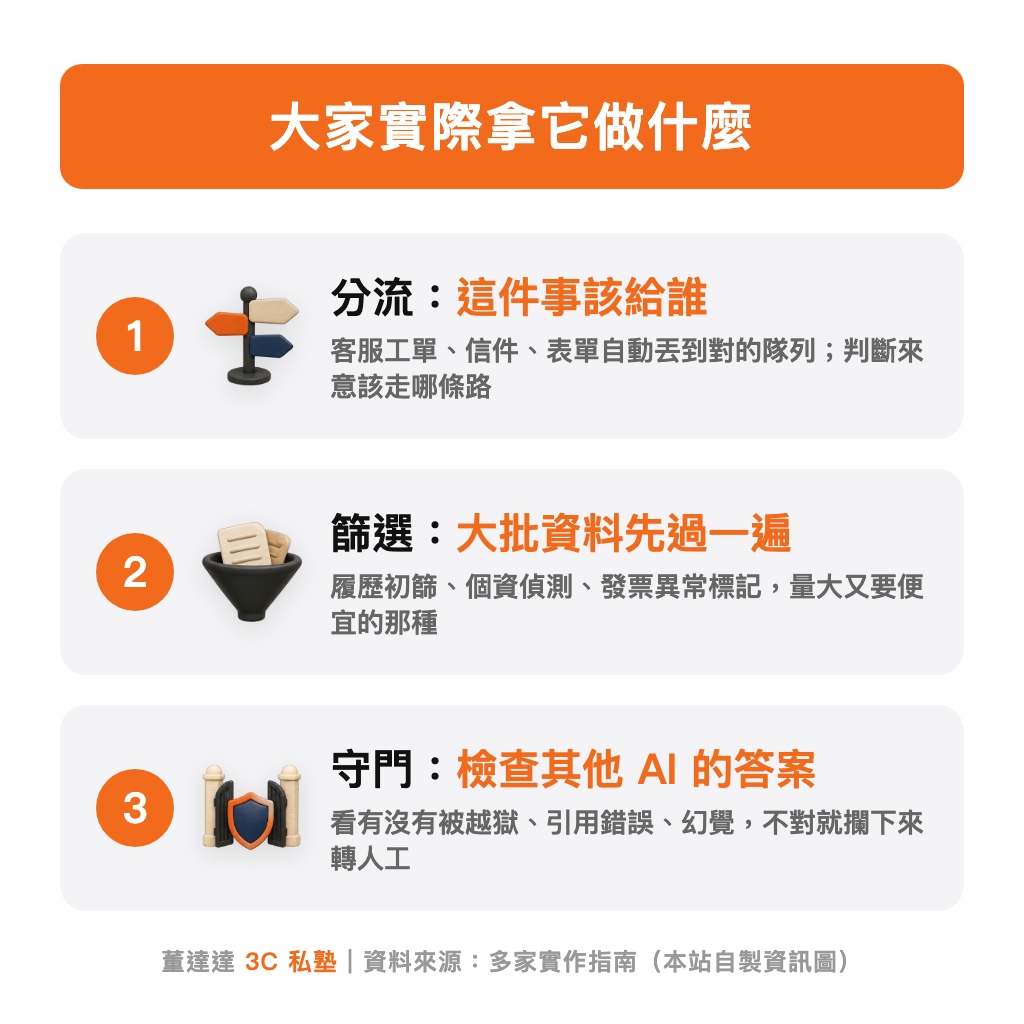
翻過這一週各家的實作指南,用途幾乎都落在同樣三類:
1. 分流:這件事該給誰
客服工單、客訴信、報修表單自動丟到對的隊列。有人示範一張「我的卡被重複扣款」的工單,一秒內被判給帳單組、信心 100%。
更進階的用法是模型路由:使用者的問題進來,先讓 Jev 判斷這題有多難,簡單的丟給便宜模型、難的才叫貴的出場。
2. 篩選:大批資料先過一遍
履歷初篩、個資偵測、程式碼審查的風險標記、發票異常。這類工作的特徵是量大、每筆判斷都不難,但用大模型跑下來帳單會很可怕。
3. 守門:檢查其他 AI 的答案
這個用途我覺得最有意思——拿它去檢查別的 AI 的輸出:有沒有被越獄、引用是不是編的、有沒有幻覺。不對就攔下來轉人工。
等於在自動化流程裡放一個便宜的稽核員。這跟我之前寫的那份「AI 做了 11 個動作、報告只寫進 1 個」的研究是同一個問題意識:你需要第二個獨立來源去驗它,而不是只看它自己寫的完工報告。
所有指南最後都收斂到同一個架構:Jev 做分類、路由、評分、守門;生成式大模型做開放式推理跟生成。它們不是替代關係,是分工。
興奮之前,3 件事先看清楚
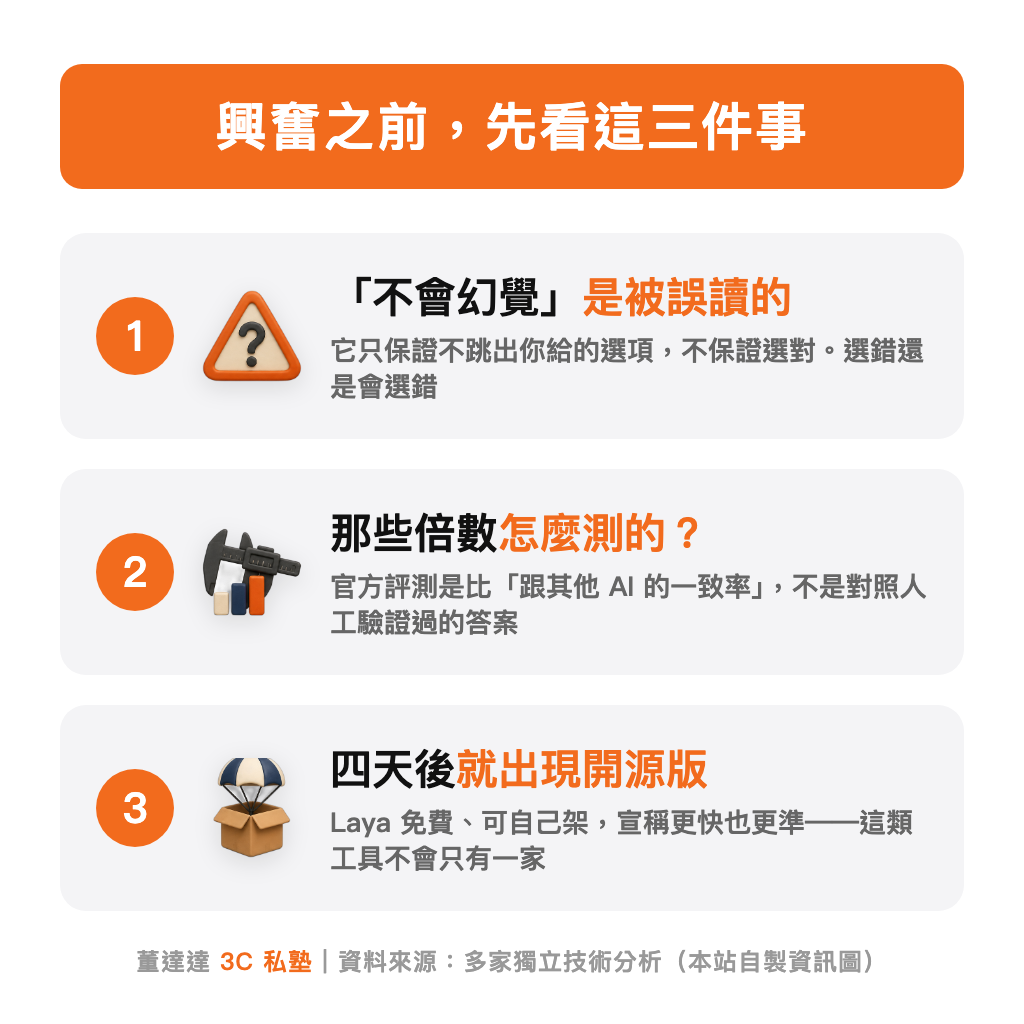
第一,「不會幻覺」這句被嚴重誤讀
很多轉述寫成「Jev 不會幻覺」,聽起來像它不會錯。實際上它保證的是不會跳出你給的選項——你給四個選項,它不會自己發明第五個。
但選錯還是會選錯。把「格式保證」當成「答案保證」,是這一週最常見的理解偏差。中文圈有一則分析把這點講得比多數英文報導都清楚,可惜傳播度遠不如那些倍數數字。
第二,那些倍數是怎麼測出來的
這是我看完整輪討論後最在意的一點。TypeSafe 的工作流程評測,是拿「跟其他前沿模型答案的一致率」當標準答案,不是對照人工驗證過的正確答案。
換句話說:它測的是「我跟別的 AI 有多像」,不是「我有多對」。
公平地說,TypeSafe 自己在發表文裡就把限制寫出來了——評測在自家筆電上跑、沒辦法證明定價沒有補貼、測試用的工作流程是自己團隊建的。願意寫這些的公司不多。但也有獨立分析指出,在整體工作流程分數上 Jev 其實落後對照組,發票處理那項落後得更明顯;目前唯一的第三方測試只涵蓋一種抽取型任務。
第三,四天後就出現了開源版
9 月 19 日,一個叫 Laya 的模型放上 Hugging Face:4.21 億參數、Apache-2.0 授權、免費可自己架,model card 宣稱比 Jev 快 7.8 倍、準確度 76.6% 對 72.7%。
更有意思的是時間序:做 Laya 的研究者早在 2025 年 3 月就把同類的決策模型連權重帶資料集放上 arXiv 了。有分析把這件事的教訓寫成一句話——模型領先不等於商業護城河。
對一般使用者來說,這件事的意義很單純:這類工具不會只有一家,現在急著綁死任何一家都太早。
我自己怎麼看這件事
9 月中上 AI Agent 課的時候,有位學員問了一個我一直記著的問題:「怎麼節省 token?有沒有自動切換模型的方式?」
當時我的回答是技術面的——到了 agent 階段,規則定好就做得到:執行某類任務時優先用哪個模型、派子任務時指定便宜的去跑。這個答案沒錯,但 Jev 這一週的爆紅讓我看到一個更清楚的說法:那個「決定該用哪個模型」的判斷本身,就值得獨立成一個超便宜的零件。
這也接得上我之前整理過的判斷框架。我在〈AI Agent 是什麼?跟 Workflow 差在哪〉把需要 agent 的情況定義成「隨機性高、需要判斷」,並舉客服系統判斷客人來意為例。Jev 正好就是專門做那一步判斷的零件——而且它證明那一層可以拆出來,不必每次都請大模型出馬。
另一個我更有感的點是查證。上週我在調一個語音工具的參數,文件上寫著支援某個語氣設定,我一直照著用,直到有人問我「你有去看過原始碼嗎」——一查才發現那個參數收了但根本沒被傳給模型,我腦補了四個月。
那次的教訓是:文件有寫不等於真的有作用。這次看 Jev 的評測方法,是完全一樣的事情——官方數字漂亮,但要追問「這個數字是拿什麼當標準答案測出來的」。
對做教育訓練的人來說,這個角度比講規格有價值得多。學員記不住「快 200 倍」,但會記住「看到倍數,先問怎麼測的」。
所以一般人現在該做什麼
如果你不寫程式,Jev 目前跟你沒有直接關係——它是給軟體用的零件,不是給人用的 app,也不會有網頁版讓你聊天。
但有一個觀念值得帶走:AI 不是只有一種。需要創意跟推理的事,找大模型;需要在固定選項裡快速判斷的事,該用便宜的工具。未來你在公司裡規劃任何 AI 流程,「這一步到底需不需要一個會寫作文的 AI」會是一個很省錢的問題。
如果你有在寫程式或做自動化,建議的姿勢是:挑一個你現在正在用大模型做分類的環節,拿它試一次,自己量延遲跟成本。不要看官方倍數,看你自己的數字。順便也去看一眼開源的那個選項。
小結
Jev 有意思的地方,不是它有多快,而是它提出了一個反直覺的方向:過去兩年 AI 的競賽都在比誰更會寫,而它證明了有一大塊需求其實只需要「判斷」。
但熱度歸熱度,三件事要記得:「不會幻覺」只是不跳出選項、那些倍數的標準答案是別的 AI、以及四天就出現的開源版說明這條路不會只有一家。
換你想想看:你手上有沒有哪件事,其實只需要一個「快速判斷」,卻一直被你丟給一個會寫作文的 AI 在做?
延伸閱讀
- AI Agent 是什麼?跟 Workflow 差在哪:3 層判斷法,先看你的流程會不會變
- AI agent 可信嗎?11 個動作只寫進報告 1 個,3 步驟自己驗收
- AI agent 為什麼推不動?Brex 執行長:改請一個「AI 員工」,3 層基礎設施缺一不可
本文整理自 TypeSafe AI 於 2026 年 9 月 15 日發表的 Jev 官方說明與後續公開資訊,並參考該模型發表後 30 天內的公開技術分析與開發者討論。文中提及的獨立開源模型 Laya 由 Convai Innovations 發布於 Hugging Face(Apache-2.0)。效能數字皆為各方官方宣稱值,尚待更多獨立驗證。
留言
張貼留言